テストの得点、科学実験の測定値、あるいは日々の売上データを集計するとき、**「平均値だけを見て判断したら一部の極端な外れ値に引っ張られていた」「手計算やツールの標準偏差がExcelの STDEV.S と一致しない」**という悩みは非常によく起こります。
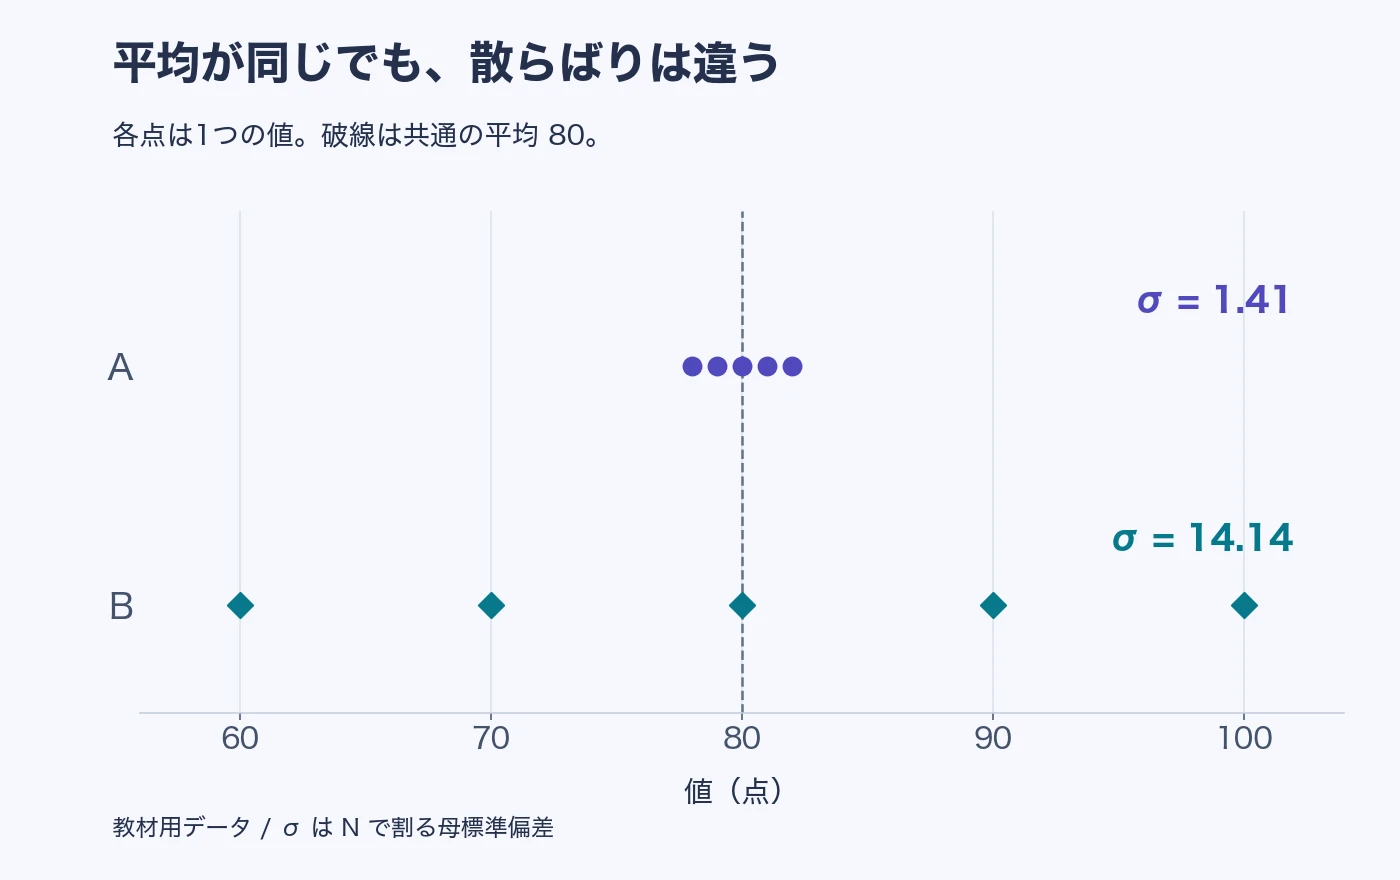
結論から言うと、データを正しく要約するには**「中心の位置(代表値)」と「散らばりの大きさ(散布度)」をペアで選ぶこと、そして標準偏差の分母が $N$(母集団)か $N-1$(不偏分散・標本)か**を明確に区別することが不可欠です。
この記事では、統計指標の4ステップ選択フローから、5人の得点データのステップ別計算表、データ数 $N$ 別の $N$ 割 vs $N-1$ 割の補正倍率・標準誤差早見表、そして外れ値があるデータでの平均値 vs 中央値・IQR比較表まで、1クリックで計算機に読み込める実例付きで解説します。
どの統計指標を使うべき? 4ステップ判断フロー
集計の目的とデータの分布形状に合わせて、次の4ステップで使うべき指標を決定します。
左右対称に近い分布で全体の合計水準が重要なら「平均値 $\bar{x}$」、極端な外れ値や偏り(年収・滞在時間など)があるなら「中央値(Median)」を主指標にします。
→ 迷ったら「平均値+中央値」を両方併記平均値を使うときは「標準偏差($\sigma$ または $s$)」、中央値を使うときは外れ値の影響を受けない「四分位範囲 $\text{IQR} = Q_3 - Q_1$」をセットで報告します。
→ $Q_1 - 1.5\text{IQR}$〜$Q_3 + 1.5\text{IQR}$ で外れ値点検手元のデータ自体が対象集団のすべてなら分母 $N$(母標準偏差 $\sigma$)、母集団から抽出したサンプルなら自由度 $N-1$(標本標準偏差 $s$)を使います。
→ $s = \sigma \times \sqrt{N/(N-1)}$ で相互換算可能平均や単位が違う集団同士のばらつき比較には「変動係数 $\text{CV} = \sigma/\bar{x}$」、標本平均の信頼区間・誤差棒には「標準誤差 $\text{SE} = s/\sqrt{N}$」を使います。
→ 個々のばらつき(SD)と平均の精度(SE)を区別代表値・散布度の6大指標と比較一覧表
NIST/SEMATECH e-HandbookおよびOpenStax Introductory Statistics 2eに基づき、実務・レポートで使う6つの統計指標を整理しました。
| 指標名(英語・記号) | 区分 | 計算式・定義 | 単位 | 外れ値への耐性 | 向いている用途・判断基準 |
|---|---|---|---|---|---|
| 相加平均(Mean, $\bar{x}$) | 代表値 | $\bar{x} = \dfrac{1}{N}\sum_{i=1}^{N} x_i$ | 元データと同じ | 弱い(外れ値に引っ張られる) | 合計値に意味がある集計、正規分布に近い測定データの中心 |
| 中央値(Median, $M_e$) | 代表値 | 昇順ソートした中央順位の値(偶数個なら中央2個の平均) | 元データと同じ | 強い(頑健 / Robust) | 年収・価格・売上など歪んだ分布や外れ値を含むデータの中心 |
| 母標準偏差(Population SD, $\sigma$) | 散布度 | $\sigma = \sqrt{\dfrac{1}{N}\sum_{i=1}^{N}(x_i - \bar{x})^2}$ | 元データと同じ | 弱い(2乗で外れ値が増幅) | テスト受験者全員など、手元のデータ全体を母集団とみなす記述統計 |
| 標本標準偏差(Sample SD, $s$) | 散布度 | $s = \sqrt{\dfrac{1}{N-1}\sum_{i=1}^{N}(x_i - \bar{x})^2}$ | 元データと同じ | 弱い(2乗で外れ値が増幅) | 実験の反復測定($N$回)など、標本から未知の母集団を推測する統計 |
| 四分位範囲(IQR) | 散布度 | $\text{IQR} = Q_3(75%点) - Q_1(25%点)$ | 元データと同じ | 強い(上下25%を除外) | 中央値とペアで使う散らばり指標、箱ひげ図と外れ値判定 |
| 変動係数(CV) | 相対散布度 | $\text{CV} = \dfrac{\sigma}{\bar{x}}$ (または $\dfrac{s}{\bar{x}}$) | 無次元(比率・%) | 弱い | 平均値の桁や単位が異なるデータ間での相対的なばらつき比較 |
例題1:5人の得点データから平均・中央値・標準偏差を手計算する
5人のテスト得点 85, 92, 78, 90, 88(単位:点)を使って、ステップごとに数値を追ってみましょう。
ステップ1:平均値と中央値を求める
- 合計: $85 + 92 + 78 + 90 + 88 = \mathbf{433\text{点}}$
- 平均値 $\bar{x}$: $433 \div 5 = \mathbf{86.6\text{点}}$
- 中央値: 小さい順に並べ替えると
78, 85, 88, 90, 92。5個の中央(3番目)にある $\mathbf{88\text{点}}$ が中央値です。(※もしデータ数が偶数個の78, 85, 88, 92なら、中央2個の平均 $(85 + 88) \div 2 = 86.5\text{点}$ になります。)
ステップ2:偏差の2乗和(平方和 $SS$)から標準偏差を求める
各得点 $x_i$ から平均 $86.6$ を引いた「偏差 $x_i - \bar{x}$」と、その2乗「$(x_i - \bar{x})^2$」を計算します。
| データ番号 $i$ | 得点 $x_i$(点) | 平均からの偏差 $x_i - 86.6$ | 偏差の2乗 $(x_i - 86.6)^2$ | 計算上のチェックポイント |
|---|---|---|---|---|
| $1$ | $85$ | $-1.6$ | $2.56$ | 平均より $1.6$ 点低い(2乗すると正の値になる) |
| $2$ | $92$ | $+5.4$ | $29.16$ | 平均より $5.4$ 点高い |
| $3$ | $78$ | $-8.6$ | $73.96$ | 平均から最も離れているため、2乗和への寄与が最大 |
| $4$ | $90$ | $+3.4$ | $11.56$ | 平均より $3.4$ 点高い |
| $5$ | $88$ | $+1.4$ | $1.96$ | 中央値($88$点)のデータ |
| 合計 / 要約 | 合計 $433$(平均 $86.6$) | 合計 $0.0$ | 平方和 $SS = 119.20$ | 偏差の合計 $\sum(x_i - \bar{x})$ は丸め誤差がなければ必ず $0$ |
平方和 $SS = 119.20$ が求まったら、目的に応じて分母 $N = 5$ または $N - 1 = 4$ で割って平方根を取ります。
-
母標準偏差(分母 $N = 5$、Tools Hubの統計計算ツール・Excel
STDEV.P): -
標本標準偏差(分母 $N - 1 = 4$、不偏分散の平方根・Excel
STDEV.S): -
💡 1クリックで計算機に読み込む:
データ数 $N$ による母標準偏差 $\sigma_N$・標本標準偏差 $s_{N-1}$・標準誤差 $\text{SE}$ の換算早見表
Tools Hubの統計計算ツールが出力する母標準偏差 $\sigma_N$(分母 $N$)から、大学の実験レポートで必要な標本標準偏差 $s_{N-1}$(分母 $N-1$)や平均値の標準誤差 $\text{SE} = s_{N-1}/\sqrt{N}$ を求めたいときは、次の換算式と倍率表を使うと電卓1回で変換できます。
| データ数 $N$ | 母標準偏差の分母 $N$(STDEV.P) |
標本標準偏差の分母 $N-1$(STDEV.S) |
換算倍率 $\sqrt{\frac{N}{N-1}}$($\sigma_N \rightarrow s_{N-1}$) | $\sigma_N$ と $s_{N-1}$ の差(%) | 標準誤差の係数 $\frac{1}{\sqrt{N}}$($s_{N-1} \rightarrow \text{SE}$) |
|---|---|---|---|---|---|
| $N = 3$(3回測定) | $3$ | $2$ | $\times 1.224745$ | $+22.47%$ | $\times 0.577350$ |
| $N = 5$(5人・5回) | $5$ | $4$ | $\times 1.118034$ | $+11.80%$ | $\times 0.447214$ |
| $N = 8$(8個データ) | $8$ | $7$ | $\times 1.069045$ | $+6.90%$ | $\times 0.353553$ |
| $N = 10$(10回測定) | $10$ | $9$ | $\times 1.054093$ | $+5.41%$ | $\times 0.316228$ |
| $N = 30$(小標本境界) | $30$ | $29$ | $\times 1.017095$ | $+1.71%$ | $\times 0.182574$ |
| $N = 100$(大標本) | $100$ | $99$ | $\times 1.005038$ | $+0.50%$ | $\times 0.100000$ |
※たとえば上の5人の得点例($N=5$)では、ツールの表示値 $\sigma_N = 4.882622$ に表の $1.118034$ を掛けると $4.882622 \times 1.118034 \approx \mathbf{5.458938}$ となり、Excelの STDEV.S(標本標準偏差 $s_{N-1}$)とピタリ一致します。
スプレッドシートや改行データを貼り付けて即座に集計
データ数・合計・平均・中央値・最小/最大・標準偏差を1クリックで算出
改行・カンマ・スペース・タブ区切りの数値を貼り付けるだけでリアルタイムに集計し、「まとめてコピー」でレポート用のテキストを出力できます。
例題2:外れ値があるデータでの「平均値 vs 中央値」「標準偏差 vs 四分位範囲(IQR)」比較表
データの中に1つでも極端な値(外れ値)が含まれると、平均値と標準偏差がどれほど大きく変化するかを3つの具体例で比較します。
| データセット例 | 入力データ(昇順) | 平均値 $\bar{x}$ | 中央値(Median) | 母標準偏差 $\sigma_N$ | 四分位範囲 $\text{IQR} = Q_3 - Q_1$ | 外れ値の影響と解釈 |
|---|---|---|---|---|---|---|
| ① 対称な5データ(外れ値なし) | 300, 350, 400, 450, 500 |
$400.0$ | $400.0$ | $70.71$ | $475 - 325 = \mathbf{150}$ | 平均値と中央値が完全に一致。平均±標準偏差が有効 |
| ② 1人だけ高年収(外れ値あり) | 300, 350, 400, 450, 5000 |
$1,300.0$($+225%$) | $400.0$(変化なし) | $1,850.68$($26.2$倍) | $2725 - 325 = 2400$(ヒンジ差は $100$) | 5000の1件だけで平均が1300へ跳ね上がるが、中央値は400で安定 |
| ③ 1週間の販売数(特売日1日) | 11, 12, 12, 13, 14, 15, 90 |
$23.86$ | $13.0$ | $27.03$ | $15 - 12 = \mathbf{3.0}$ | 通常日の中心は中央値13個(IQR 3個)。90個の日は背景要因を別記 |
- 💡 1クリックで計算機に読み込む: 外れ値のある年収例(300, 350, 400, 450, 5000)を統計計算ツールで開く
外れ値を勝手に削除してはいけない理由
③の週間販売数(11, 12, 12, 13, 14, 15, 90)では、第1四分位数 $Q_1 = 12$、第3四分位数 $Q_3 = 15$、四分位範囲 $\text{IQR} = 3$ となり、外れ値の上限基準 $Q_3 + 1.5\times\text{IQR} = 15 + 4.5 = 19.5$ を大きく超える 90 が検出されます。
しかし、この 90 が**「単なる桁の打ち間違い(入力ミス)」なのか「週末の特売キャンペーンによる実際の急増」なのか**は数値だけでは決まりません。外れ値を見つけたときは無条件にデータから除外せず、①単位・桁区切りの入力確認、②測定条件・イベント履歴の照合を行い、除外する場合はその理由をレポートに明記してください。
統計計算から次の分析へ進む連携ステップ
平均値と標準偏差を求めたら、目的に応じて以下のツールと解説記事へそのまま進めます。
- 個人の得点が集団のどの位置(上位何%)にあるか知りたいとき: 求めた平均点 $\mu$ と標準偏差 $\sigma$ を使って、偏差値の求め方と逆算公式ガイドおよび偏差値計算ツールで偏差値(Tスコア)と正規分布パーセンタイルを算出できます。
- 2変数 $(x, y)$ の相関や検量線(直線フィット)を求めたいとき: 最小二乗法と線形回帰の計算ガイドおよび最小二乗法計算ツールで傾き・切片・決定係数 $R^2$ を求められます。
- 測定値の標準偏差(不確かさ)を計算式の結果へ伝播させたいとき: 誤差伝播計算ツールで合成標準不確かさを計算できます。最終報告値の丸め方は有効数字の数え方と計算ルールを確認してください。
この記事の確認範囲
本記事の定義・数式・5データおよび外れ値データの計算例・換算倍率は、2026年10月27日にOpenStax Introductory Statistics 2e、NIST/SEMATECH e-Handbook、およびMicrosoft Excel関数仕様と照合し再検算しています。数学カテゴリの計算ツール一覧から関連する統計・解析ツールをあわせてご利用いただけます。
よくある質問
標準偏差を計算するとき、Nで割る(母標準偏差)とN−1で割る(標本標準偏差)はどう使い分けますか?
手元のデータそのもの(例:クラス全員のテスト得点、全数検査の結果)の散らばりを記述したいときは N で割る「母標準偏差 σ(Excelの STDEV.P)」を使います。一方、一部だけ抜き取ったサンプル(例:5回の反復実験データ、抽出アンケート)から背後の母集団全体のばらつきを推定したいときは、標本平均を使うことによる過小評価バイアスを補正するため N−1(自由度)で割る「標本標準偏差 s(Excelの STDEV.S)」を使います。なお、Tools Hubの統計計算ツールは N で割る母標準偏差を標準表示します。
平均値と中央値が大きくズレているときは、どちらを使うべきですか?
少数の極端な高値・低値(外れ値)や左右非対称の歪んだ分布(世帯年収やキャンペーン日の売上など)では、平均値が外れ値に強く引っ張られます。例えば 300, 350, 400, 450, 5000(万円)では平均値は 1,300万円になりますが、5人中4人は450万円以下であり、典型的な水準を表すには中央値(400万円)の方が適しています。レポートではどちらか一方を隠すのではなく「平均値と中央値の両方」を併記するのが最も誠実です。
標準偏差(SD)と標準誤差(SE / SEM)はどう違いますか?
標準偏差(SD: σ または s)は「個々のデータが平均値の周りでどれくらい散らばっているか」を表す指標です。これに対し、標準誤差(SE = s ÷ √N)は「標本平均 x̄ が真の母平均 μ からどれくらいブレるか(平均値の推定精度)」を表します。データ数 N を増やすと標準誤差 SE は 1/√N に比例して小さくなりますが、元のデータの散らばりである標準偏差 SD は 0 には近づきません。
単位や平均値が大きく異なる2つのデータのばらつきはどう比較しますか?
標準偏差は元のデータと同じ単位を持つため、平均値が10倍違うデータや「身長(cm)と体重(kg)」のように単位が異なるデータの散らばりを標準偏差の大小で直接比較することはできません。その場合は、標準偏差を平均値で割った無次元量の「変動係数 CV = 標準偏差 ÷ 平均値」を計算して相対的なばらつきを比較します。
外れ値を機械的に見分ける数値基準(1.5×IQRルール)とは何ですか?
データを小さい順に並べた下位25%点(第1四分位数 Q₁)と上位25%点(第3四分位数 Q₃)の差を四分位範囲 IQR = Q₃ − Q₁ と呼びます。箱ひげ図(Tukeyの基準)では、「Q₁ − 1.5 × IQR 未満」または「Q₃ + 1.5 × IQR 超」の値を外れ値候補として検出します。ただし、検出された値を無条件に削除せず、測定ミス・入力ミスか実際の現象かを必ず確認してください。